« L’IA permet d'aller plus vite, mais il ne faut pas perdre de vue que c'est l'humain qui doit rester au cœur de la science. »
Rencontre avec Thierry Poibeau, directeur de recherche CNRS au laboratoire Langues, Textes, Traitements informatiques, Cognition (CNRS/ENS-PSL/Université Sorbonne Nouvelle).
Créé le
23 septembre 2025
Spécialiste du traitement automatique des langues et des grands modèles de langue (LLMs), Thierry Poibeau travaille sur les relations entre langage, intelligence artificielle et cognition. Ses recherches portent notamment sur les applications de l’IA à l’analyse des textes littéraires et aux sciences sociales, ainsi que sur les impacts sociétaux des technologies d’IA.
Thierry Poibeau vient d’obtenir une ERC Advanced Grant 2025 pour le projet CANON (Computational Analysis of Narratives and the Organization of Novels).
Pouvez-vous nous expliquer quelles sont les recherches visées et qui constituent le projet CANON (Computational Analysis of Narratives and the Organization of Novels ) ?
Thierry Poibeau : CANON part d'un objectif simple à formuler, mais ambitieux à mettre en œuvre : analyser de grands corpus de textes littéraires (des romans), pour en dégager les thèmes, et surtout observer comment évoluent les formes et les genres dans le temps. L'idée centrale est de modéliser des notions qui restent aujourd'hui largement hors de portée des outils existants : la forme d'un roman, son intrigue, la manière dont il construit le suspense. Ce sont des dimensions qui ont fait l’objet de nombreuses recherches (en narratologie, notamment), mais qui restent assez peu formalisées et que l'analyse computationnelle peine donc encore à saisir à grande échelle. Le projet est aussi comparatiste : il ne se limite pas à la seule tradition française, mais s'intéresse également aux traditions italienne et russe, pour mieux comprendre les transferts et les influences qui circulent d'une littérature à l’autre.
Concrètement, comment se fait le travail sur un corpus de textes et quels seront les textes étudiés ?
Thierry Poibeau : Le cœur du corpus s'appuiera sur les collections de romans de la Bibliothèque nationale de France (BnF), avec laquelle nous avons noué un partenariat, une ressource patrimoniale considérable, qui donne accès à un très grand nombre de textes sur une longue période. À cela s'ajouteront des corpus issus des traditions italienne et russe, pour permettre les comparaisons entre aires littéraires. Sur le plan méthodologique, le travail repose sur des approches informatiques, en particulier les grands modèles de langue, qui nous servent à traiter ces volumes de textes bien au-delà de ce qu'une lecture humaine pourrait couvrir, tout en cherchant à leur faire modéliser des notions littéraires fines, comme la forme, l'intrigue ou le suspense, qui échappent encore largement aux outils actuels. Ce travail à grande échelle ne se substitue pas pour autant à la lecture : il s'articule avec des phases de lecture rapprochée, qui servent à vérifier, affiner et corriger ce que proposent les modèles. La supervision humaine reste ainsi présente à chaque étape, pour que les résultats produits par les outils restent fidèles à la réalité des textes.
Ce mois-ci, les éditions rue d’Ulm publient votre livre Les Mots sans les choses. Philosophie, éthique et impact des grands modèles de langue. Pouvez-vous nous le présenter en quelques mots ?
Thierry Poibeau : C'est un ouvrage qui s'intéresse aux conséquences des LLMs, les grands modèles de langue : quelle représentation du langage proposent-ils, et en quoi sont-ils des outils qui font évoluer nos connaissances en linguistique, en sciences cognitives, en philosophie ? Le livre s'attache aussi aux conséquences pratiques et sociales de l'IA sur la société contemporaine. Il ne s'agit donc pas seulement d'une réflexion théorique, mais aussi d'un regard sur ce que ces outils changent concrètement.
Pouvez-vous définir ce que sont ces programmes d'intelligence artificielle appelés les grands modèles de langue (LLMs) ?
Thierry Poibeau : Ce sont, à la base, des modèles statistiques : ils apprennent, à partir d'immenses quantités de textes, à prédire la suite d'une phrase, mot après mot. Mais à cette échelle, cet apprentissage produit quelque chose qui dépasse la simple prédiction. Ces outils sont à la fois des modèles de production linguistique (capables de générer des textes cohérents, dans des styles et des registres très variés) et d'immenses réservoirs de connaissances, puisqu'ils ont absorbé une part considérable de ce qui a été écrit et mis en ligne. Et aujourd'hui, ces outils savent aussi raisonner, au sens où ils peuvent analyser un énoncé, en tirer des conséquences, enchaîner plusieurs étapes de raisonnement, et produire en réponse des textes structurés et argumentés. C'est cette combinaison (langage, connaissances, raisonnement) qui distingue ces outils des systèmes de traitement automatique des langues qu'on connaissait il y a encore quelques années.
Alors que le fait de vivre avec l'IA semble inévitable, comment, selon vous, de nouveaux cadres normatifs peuvent entourer son utilisation ?
Thierry Poibeau : Il est difficile d'anticiper des cadres normatifs pour une technologie encore en plein développement, mais c'est bien l'un des enjeux du moment. Les développeurs de ces technologies doivent prendre leurs responsabilités, ce qui est encore loin d'être le cas aujourd'hui. Il est clair, par exemple, que l'IA ouvre des possibilités inédites en matière de cyberattaques : les États ne sont pas préparés, et les cadres normatifs, mais aussi, plus simplement, les pratiques, doivent évoluer rapidement pour faire face à ce type de menace.
À votre avis, quels vont être les effets de l'IA sur la société et la production du savoir ?
Thierry Poibeau : L'IA a déjà profondément changé la recherche dans de nombreux domaines : les mathématiques, la biologie, mais aussi les sciences humaines par exemple. L'enjeu est de bien cerner ce qui se joue réellement, et de réfléchir à la manière de préserver la crédibilité de la science face à l'accélération et à l'automatisation partielle de la production des savoirs. L'IA permet d'aller plus vite, mais il ne faut pas perdre de vue que c'est l'humain qui doit rester au cœur de la science.
Lors de la Nuit des données à l'ENS le 25 septembre 2026, vous interviendrez sur le thème « Faire parler 4 000 sonnets : données et poésie combinatoire ». En quelques mots, de quoi sera-t-il question ? Pourquoi avoir choisi ce sujet sur le rôle des données dans les humanités numériques ?
Thierry Poibeau : Ce projet résulte d'une collaboration avec la BnF. Il mobilise des outils plutôt low-tech, pas de l'IA dernière génération. L'idée était de présenter un projet à trois facettes : patrimoniale, avec la constitution d'un corpus de plus de 4 000 sonnets ; ludique, en reprenant le principe de production combinatoire exploré par Raymond Queneau dans « Cent mille milliards de poèmes » ; et enfin réflexive, en interrogeant la place des approches informatisées en littérature, et plus largement dans les sciences humaines et sociales.
En quoi un événement comme la Nuit des données vous semble-t-il important aujourd'hui pour rapprocher la recherche en IA du grand public ? Et quel regard souhaitez-vous y partager ?
Thierry Poibeau : La période actuelle, et cette interview elle-même, montre bien que nous sommes à un moment charnière dans l'évolution des sciences, en particulier de l'IA, et de leurs rapports avec la société. La Nuit des données permet justement d'ouvrir ce dialogue avec le grand public, de faire connaître les enjeux des développements actuels et leurs conséquences, possibles voire probables, sur la société.
A propos de Thierry Poibeau Thierry Poibeau, directeur de recherche CNRS au laboratoire Langues, Textes, Traitements informatiques, Cognition (CNRS/ENS-PSL/Université Sorbonne Nouvelle) pour le projet CANON « Computational Analysis of Narratives and the Organization of Novels » Thierry Poibeau est directeur de recherche CNRS, affecté au laboratoire Langues, Traitements informatiques, Textes et Cognition (LATTICE) et titulaire d’une chaire PRAIRIE-PSAI (Paris Artificial Intelligence Research Institute–Paris School of Artificial Intelligence). Il est l’auteur de plusieurs ouvrages, dont Babel 2.0. Où va la traduction automatique ? (Éditions Odile Jacob, 2019) et Les mots sans les choses (Éditions Rue d’Ulm, 2026). Il participe régulièrement aux débats publics sur l’intelligence artificielle, ses usages et sa gouvernance. |
La Nuit des données à l’ENS - 25 septembre 2026
La Nuit des données 2026 : le festival sciences, lettres et sciences humaines de l'École normale supérieure pour explorer les données et l’intelligence artificielle
Le vendredi 25 septembre 2026, de 17h à minuit, l'École normale supérieure (ENS-PSL) ouvre ses portes pour La Nuit des données, nouvelle édition de La Nuit de l'ENS, son festival Sciences & Lettres. Gratuit sur inscription et ouvert à toutes et tous, cet événement réunit les chercheuses et chercheurs de l'ENS et leurs invités pour une programmation inédite de plus de 70 conférences, débats, tables rondes, ateliers, expositions, spectacles pour explorer les données et l’IA sous toutes leurs formes.
De l'intelligence artificielle à la santé, du climat à la géopolitique, de la physique à la philosophie, cette soirée proposera un dialogue inédit entre les disciplines pour éclairer l'un des grands sujets scientifiques et sociétaux de notre époque.
Entrée gratuite - inscription et programme ici
→ Intervention de Thierry Poibeau lors de la Nuit des données : « Faire parler 4 000 sonnets : données et poésie combinatoire »
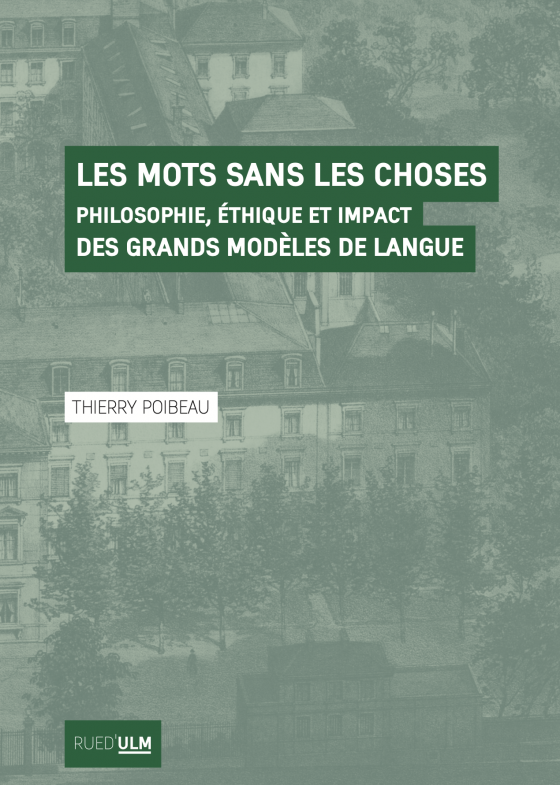
Les Mots sans les choses
Philosophie, éthique et impact des grands modèles de langue
Thierry Poibeau
Disponible en septembre 2026 sur www.presses.ens.psl.eu en version électronique et impression à la demande. Éditions rue d’Ulm, Coll. « Actes de la recherche à l’ENS-PSL » n° 41.
A lire aussi
« Quand l’informatique se mêle de poésie : Rencontre avec Thierry Poibeau, directeur adjoint du laboratoire LATTICE, spécialiste du traitement automatique des langues.» Lire l'article consacré à Thierry Poibeau sur le site de l'ENS.